Arquitectura para la resiliencia
En este tema se ofrece una descripción general de las soluciones tolerantes a fallos que se pueden conseguir con Network Edge.
Diseñar soluciones con resiliencia es uno de los aspectos más críticos de la arquitectura de redes y perimetrales. Si bien no hay una respuesta correcta a la cantidad de resiliencia que se necesita, hay mejores prácticas, sugerencias para diferentes casos de uso y algunos servicios y características específicos que ofrece Network Edge.
La plataforma de virtualización de funciones de red subyacente (NFV) que proporciona la infraestructura para Network Edge es inherentemente tolerante a fallos desde el punto de vista de una sola instancia virtual. Aún así, debe diseñar la resiliencia en la solución general para lograr la máxima redundancia posible. Este documento explica cómo lograr la resiliencia utilizando la naturaleza inherente de la plataforma complementada por las características tolerantes a fallos de Network Edge.
Niveles de redundancia
Imagine un diseño de red desde el origen de un paquete de datos y moviéndose desde adentro hacia afuera hasta su destino. En ese caso, cada punto donde se procesa o atraviesa el tráfico se convierte en un posible punto de fallo. La clave es diseñar contra un evento impactante en los puntos de recorrido.
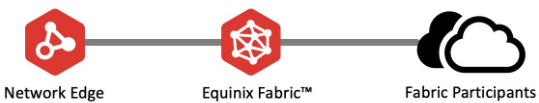
En un flujo de red simple desde un dispositivo Network Edge a un participante de Equinix Fabric, como se muestra en el siguiente gráfico, los flujos de tráfico tienen tres puntos distintos: Dispositivo virtual Network Edge, Equinix Fabric y la conexión de participante de la tela. Hay redundancia inherente entre el dispositivo virtual Network Edge y Equinix Fabric, por lo que la arquitectura Hoja o Spine que interconecta la plataforma NFV subyacente a la tela es redundante. No hay redundancia inherente entre Equinix Fabric y el participante de la tela. Para lograr la máxima redundancia, debe implementar una solución que utilice diferentes planos de conectividad para aprovechar el flujo de red completo.
Planos primarios y secundarios
El Network Edge se basa en una arquitectura estándar de redundancia de centro de datos con múltiples puntos de despliegue (pods) que tienen energía dedicada suministrada. El concepto de aviones primarios y secundarios está detrás del despliegue de Network Edge y Equinix Fabric. Network Edge utiliza los planos primario y secundario utilizando la separación por cómputo a través de la afinidad. Cada dispositivo virtual en un par tolerante a fallos se implementa en su clúster respectivo. Aunque se conoce como plano primario y plano secundario, hay múltiples planos de cómputo en cada cápsula Network Edge. El número real varía según el tamaño del metro. Esto permite que los dispositivos se desplieguen de una manera en la que no se mezclen en el mismo plano de cómputo, eliminando el cómputo como un único punto de falla (SPOF).
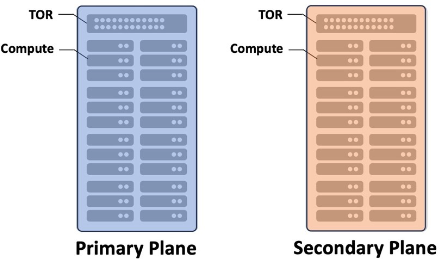
Los switches Equinix Fabric son parte de un grupo de chasis que consiste en switches primarios y secundarios. Las designaciones de conmutador primario y secundario para el grupo de chasis son simplemente una forma de identificar los conmutadores desde un punto de vista de nomenclatura y no muestran los flujos de tráfico. Active-Active o Active-Standby desde el punto de vista de enrutamiento se configuran en el dispositivo Network Edge y están completamente bajo su control. La documentación de Arquitectura de Plataforma discute más detalles sobre la arquitectura fundacional de Network Edge.
Un firewall VNF llamado NGFW-A se ha implementado previamente. Para implementar un router VNF en el plano secundario, utilice Diversa Compute desde una característica de dispositivo único existente y seleccione NGFW-A en el menú desplegable.
Definición de resistencia de dispositivos y conexiones
Network Edge ofrece múltiples opciones de resiliencia que se pueden resumir como opciones de dispositivo y opciones de conexión. Las opciones de dispositivos son locales y proporcionan resistencia contra fallos a nivel de cómputo y dispositivo en el metro local. Esto es análogo a lo que la industria típicamente se refiere como “Alta Disponibilidad (HA)”. La resiliencia de conexión es una opción separada para los clientes que requieren resiliencia adicional con conexiones de dispositivos (redes DLGS, VCS y EVP-LAN).
Es habitual combinar tanto la resiliencia local como la resiliencia de conexión, pero no es obligatorio; en última instancia, depende de los requisitos empresariales del cliente.
La geo-redundancia es una arquitectura que expande la resiliencia local mediante la utilización de múltiples metros para eliminar problemas que pueden afectar a Network Edge a nivel del metro. La geo-redundancia se discute en detalle aquí.
Dispositivos individuales (autónomos) - Opción de resistencia local
Los dispositivos únicos o independientes no tienen resistencia para los fallos de cómputo y dispositivo. El primer dispositivo siempre está conectado al plano de computación principal. Los dispositivos individuales siempre hacen conexiones a través de la red principal de Fabric. Los dispositivos individuales pueden construir conexiones redundantes (VCs, DLGS, etc.) pero siempre atravesarán el plano principal de la tela. Los dispositivos individuales se pueden convertir en dispositivos redundantes a través de la función anti-afinidad.
Antiafinidad de un solo dispositivo
Como se describió anteriormente, los dispositivos individuales no tienen resiliencia por defecto. Sin embargo, los dispositivos individuales se pueden colocar en planos de cómputo divergentes. Esto se llama comúnmente anti-afinidad y está disponible en el flujo de trabajo de creación de dispositivos. Bajo la sección de Computación Diversa de un solo dispositivo existente, la comprobación de la BOX "Seleccionar diverso de" permite a los clientes agregar nuevos dispositivos que sean resistentes entre sí.

Dispositivo virtual redundante frente a clúster
Los flujos de trabajo de Network Edge garantizan que los dispositivos virtuales emparejados en una implementación tolerante a fallos se coloquen en los planos de cómputo primario y secundario. Hay dos tipos de implementaciones tolerantes a fallos: Dispositivos redundantes y dispositivos agrupados.
Estas opciones proporcionan resistencia local (intra-metro) para proteger contra fallos de hardware o energía en el POD local de Network Edge. Por defecto, los dos dispositivos virtuales se despliegan en planos de cómputo separados (primario y secundario) y son distintos entre sí. El dispositivo primario está conectado a la red de tejido primario y el dispositivo secundario/pasivo está conectado a la red de tejido secundario. La selección del tipo de implementación está disponible en el flujo de trabajo de creación de dispositivos en el portal.

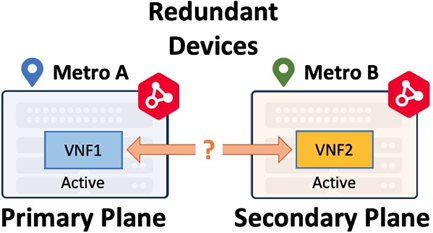
Las instancias virtuales redundantes se implementan en diferentes planos de cómputo para la redundancia. No tienen flujos de trabajo de nivel superior, lo que significa que los dispositivos no son conscientes entre sí después de la implementación inicial y funcionan como dos dispositivos virtuales distintos. Típicamente, los dispositivos redundantes funcionan de una manera Activo-Activo. Las instancias virtuales redundantes se pueden desplegar en un mismo metro o a través de metros. El dispositivo redundante en un solo metro solo proporciona resiliencia local. El despliegue de geo-redundancia (dispositivos redundantes a través de METROS) proporciona una resiliencia mucho mayor. Cuando un dispositivo redundante se despliega en otro metro, todavía se despliega en el plano de cómputo secundario.
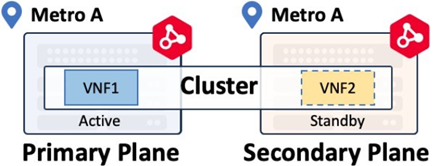
Las instancias virtuales del clúster tienen flujos de trabajo de nivel superior que implementarán un par de dispositivos Active-Standby según lo definido por el proveedor respectivo. Compruebe la documentación para verificar el soporte de clúster para su dispositivo virtual. Los dispositivos de clúster solo se pueden desplegar dentro del mismo metro.
Conexiones virtuales
Las conexiones virtuales le permiten especificar el nivel de resiliencia que requiere su implementación. Los flujos de trabajo son flexibles, permitiendo múltiples escenarios para acomodar la redundancia, si es necesario.
Los flujos de trabajo de conexión virtual difieren entre las implementaciones redundantes y clúster. Las conexiones de dispositivo redundantes se originan en cada dispositivo virtual individual en el par redundante, mientras que las conexiones de dispositivo en clúster se originan en el clúster.
Conexiones virtuales redundantes
Los dispositivos redundantes se despliegan en diferentes planos de cómputo utilizando afinidad. Una vez implementados, los dispositivos no comparten ninguna información de configuración y funcionan como dos dispositivos independientes. Para lograr la redundancia a través del participante de la tela, se crean conexiones virtuales en la tela primaria y secundaria como se muestra a continuación. El plano primario se conecta a la red de tejido primario (o plano de tejido primario) y el plano secundario se conecta a la red de tejido secundario.
Este es uno de los conceptos más importantes para entender la resiliencia Network Edge. El plano del dispositivo determina qué red de tela (o plano de tela) se utiliza para las conexiones del dispositivo.
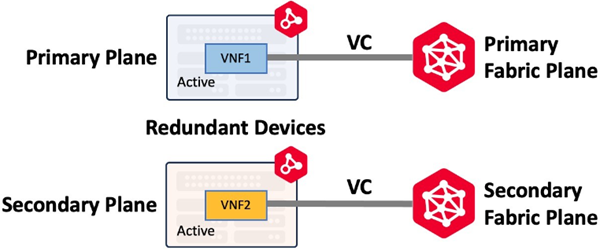
Los dispositivos redundantes se pueden desplegar en el mismo metro o en diferentes metros, lo que le permite construir soluciones redundantes que abarcan distancias geográficas. Los flujos de trabajo son flexibles y puede crear conexiones tanto en el plano de tejido primario como secundario o en cada plano según sea necesario para su caso de uso.
Conexiones virtuales del clúster
Los dispositivos agrupados se despliegan en los planos de computación primario y secundario y tienen flujos de trabajo de nivel superior para construir un par de dispositivos virtuales Activo-Activo o Activo-Estable.
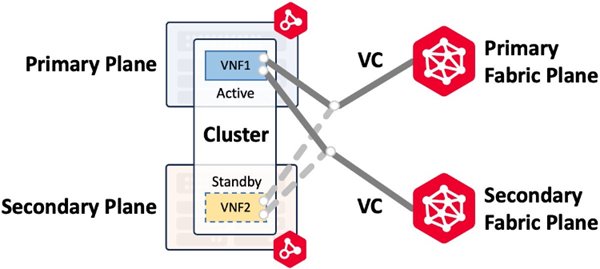
Los clusters se pueden construir solo en el mismo metro. Por ejemplo, si un circuito virtual está construido tanto en el plano de tejido primario como secundario, el flujo de trabajo creará dos conexiones al clúster y asignará una interfaz para cada conexión a ambos nodos del clúster. La imagen siguiente (Conectando al mismo Metro/mismo proveedor) muestra una conexión de tejido principal y secundaria a un clúster de espera activa con cluster-node0 activo y cluster-node1 en espera. En el caso de una conmutación por error del clúster y cluster-node1 se activa, las conexiones se mueven a cluster-node1.
| Dispositivos redundantes | Dispositivos agrupados | |
|---|---|---|
| Despliegue | Dos dispositivos, ambos activos, que aparecen como dos dispositivos en el portal de Network Edge. Ambos dispositivos tienen todas las interfaces de reenvío | Dos dispositivos, solo uno está siempre activo. El plano de datos del dispositivo pasivo (no activo) no se está reenviando |
| Gestión de la WAN | Ambos dispositivos obtienen una dirección L3 única que está activa para la gestión de la WAN | Cada nodo obtiene una dirección L3 única para la gestión de la WAN, así como una dirección Cluster que conecta con el nodo activo (ya sea 0 ó 1) |
| Grupos de enlace de dispositivos | No se crea ninguno al inicio del dispositivo | Se crean dos por defecto para compartir la sincronización de la configuración y la comunicación en caso de fallo |
| Conexiones virtuales de Fabric | Las conexiones pueden realizarse a uno o a ambos dispositivos | Las conexiones individuales se construyen en un VNI especial que se conecta solo al nodo de Active Cluster. El cliente puede crear conexión secundaria opcional y adicional (s) |
| Admite redundancia geográfica | Sí, se pueden desplegar dispositivos redundantes en diferentes metros | No, los dispositivos de clúster sólo pueden desplegarse en el mismo metro |
| Apoyo a proveedores | Todos los vendedores | Cortafuegos Fortinet FortiGateCortafuegos Juniper vSRXNGINX PlusCortafuegos Palo Alto de la serie VM |
Todos los escenarios mostrados en las siguientes ilustraciones asumen que el Participante del Proveedor se conecta tanto a la Tela Primaria como a la Secundaria. Si hay alguna pregunta sobre las conexiones de tela redundantes, consulte con su Arquitecto de Soluciones Globales de Equinix.
Conexión al mismo metro/mismo proveedor
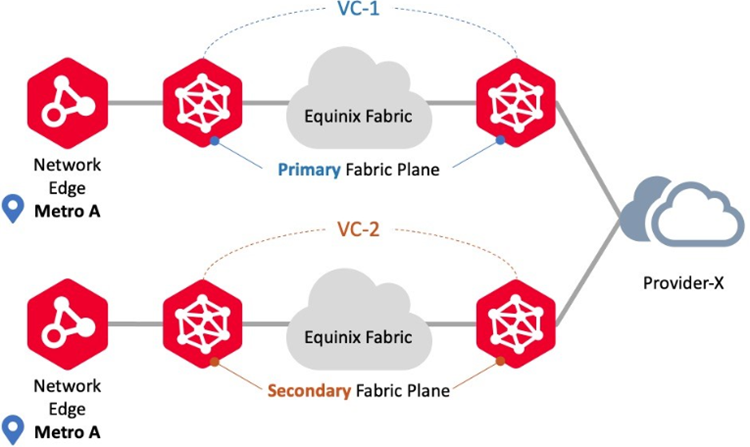
Utilice este escenario de conexión para conectarse al mismo proveedor mediante dispositivos Network Edge en la misma ubicación de metro. En este escenario, Network Edge admite implementaciones redundantes y de clúster. Los flujos de trabajo de circuitos virtuales garantizan que cada circuito se aprovisione en los planos de tejido primario y secundario, respectivamente. Un ejemplo son las conexiones redundantes con los mismos participantes de Fabric.
Conectarse al mismo metro o a distintos proveedores
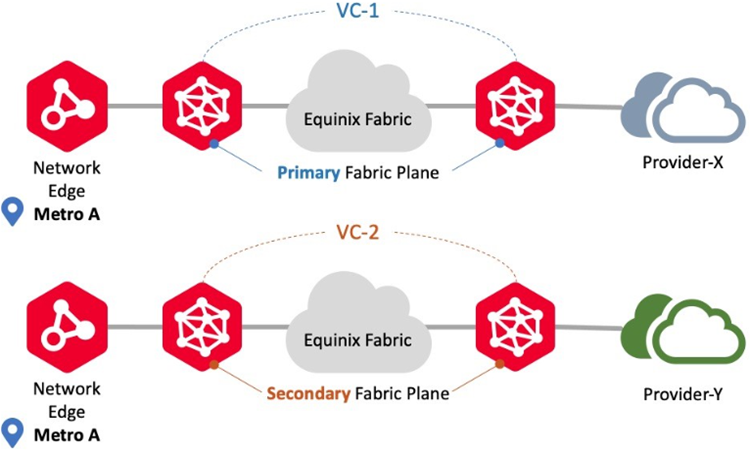
Utilice este escenario de conexión para conectarse a diferentes proveedores que utilizan dispositivos Network Edge en la misma ubicación de metro. En este escenario, Network Edge admite implementaciones redundantes y de clúster. Los flujos de trabajo de circuitos virtuales garantizan que cada circuito se aprovisione en los planos de tejido primario y secundario, respectivamente. Un ejemplo son las conexiones redundantes a diferentes participantes de Fabric.
Conectarse a otro metro o al mismo proveedor
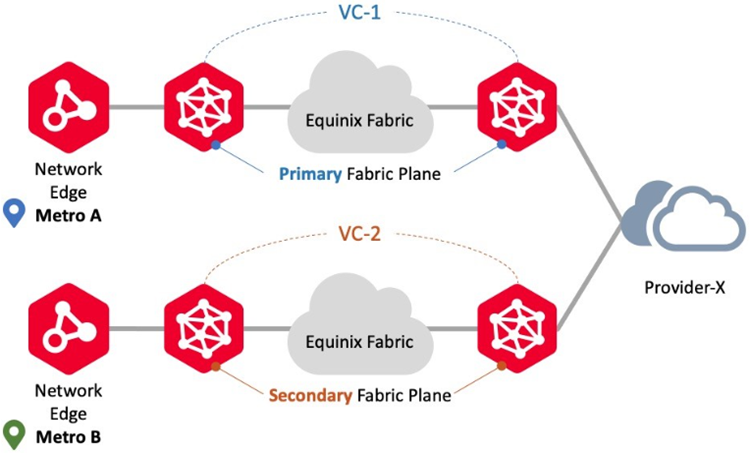
Utilice este escenario de conexión para conectarse a los mismos proveedores mediante instancias virtuales de Network Edge en diferentes ubicaciones de metro. En este escenario, Network Edge admite implementaciones redundantes, pero no admite implementaciones de clúster. Los flujos de trabajo de circuitos virtuales garantizan que cada circuito se aprovisione en los planos de tejido primario y secundario, respectivamente. Un ejemplo son las conexiones redundantes desde dos metros diferentes al mismo participante de Fabric.
Conectarse a diferentes metros/diferentes proveedores
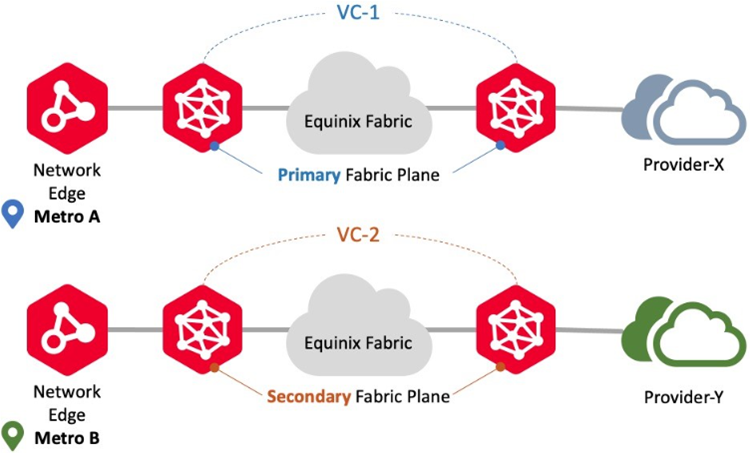
Utilice este escenario de conexión para conectarse a diferentes proveedores que utilizan dispositivos Network Edge en diferentes ubicaciones del metro con diferentes participantes de Tela. En este escenario, Network Edge admite implementaciones redundantes, pero no admite implementaciones de clúster. Los flujos de trabajo de circuitos virtuales garantizan el aprovisionamiento para cada circuito en los planos de tejido primario y secundario, respectivamente. Un ejemplo son las conexiones redundantes de dos metros diferentes a los diferentes participantes de Fabric.
Grupos de enlace de dispositivo
Un grupo de enlace de dispositivos (DLG) es un servicio de Network Edge con el que dos o más dispositivos virtuales pueden conectarse como un grupo dentro o a través de múltiples metros. Un DLG se utiliza típicamente para el encadenamiento de servicios (conectando varios tipos de dispositivos, como firewall y routers, juntos), la columna vertebral, o para propósitos de redundancia.
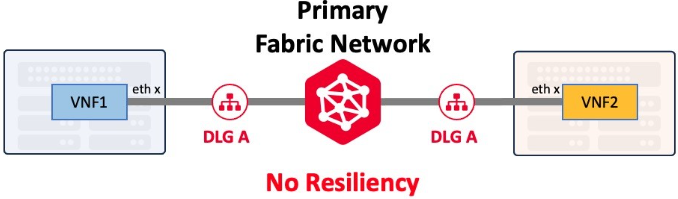
DLGS se puede crear con o sin redundancia. Un solo DLG, como un solo cable Ethernet, no proporciona resistencia. Los clientes que requieran máxima resiliencia deben implementar DLGS adicionales que se conecten tanto a las redes de tejido primario como secundario.
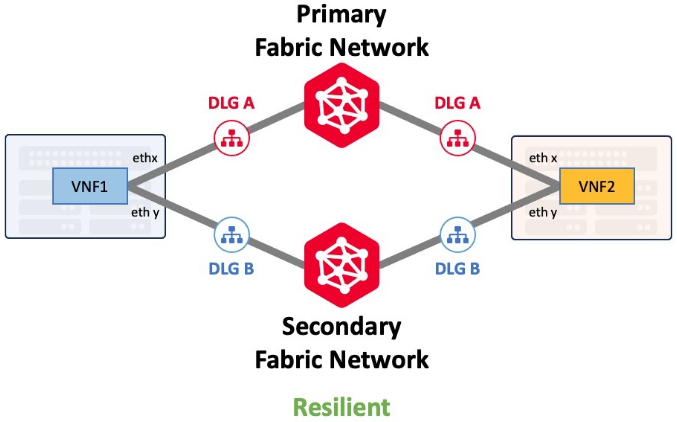
Device Link y su capacidad de redundancia se discute en detalle en Device Link Resiliency.
Redes EVP-LAN
Network Edge soporta la conexión EVP-LAN para permitir la conexión de multipunto a multipunto. EVP-LAN le permite interconectar sus activos de centro de datos en muchas ubicaciones a través de una red común en lugar de requerir conexiones directas entre ubicaciones individuales. Este tema describe cómo crear una red privada multipunto a multipunto y conectarse a esa red desde sus dispositivos Network Edge.
Las EVP-LAN difieren de las DLGS en que se conectan a dispositivos Network Edge y puertos de tela. Varios dispositivos Network Edge en el mismo metro pueden formar parte de la misma red EVP-LAN. Los clientes que requieren máxima resiliencia deben implementar EVP-LAN adicionales que abarcan tanto las redes de tejido primario como secundario.
Para una resiliencia adecuada, cada dispositivo en el par de dispositivos redundantes requerirá una sola conexión a dos redes EVP-LAN diferentes. El dispositivo primario en el plano primario utilizará la red principal de la tela. El dispositivo secundario en el plano secundario utilizará la red de tejido secundario.
Los dispositivos agrupados son diferentes en el sentido de que el flujo de trabajo permite crear conexiones a las redes de Fabric primaria o secundaria.
Temas conexos